La ridondanza nella Continuità Operativa dei siti web
Contenuti
- Due non significa sempre ridondante
- La ridondanza deve essere indipendente
- La ridondanza non riguarda soltanto l’infrastruttura
- Non tutto deve essere ridondato
- Anche il provider fa parte del ragionamento
- La ridondanza non è continuità finché non sai cosa succede
- Dalla componente al processo
- Approfondimenti
- Per 11 giorni nessuno si è accorto che il sistema era rotto.
Quando si parla di Continuità Operativa, la ridondanza è uno dei primi concetti che vengono in mente.
L’idea è semplice: se un componente si guasta, deve esistere un’alternativa in grado di permettere al servizio di continuare.
Server, alimentazione, connessioni di rete, sistemi di archiviazione e servizi possono essere progettati con componenti o percorsi alternativi. La ridondanza può quindi ridurre la probabilità che il guasto di un singolo elemento interrompa il funzionamento del sistema.
Ma la Continuità Operativa non coincide con la ridondanza.
L’interruzione della capacità di un sito di produrre valore può dipendere da molti fattori diversi: un errore umano, una dipendenza esterna, una configurazione errata, una procedura inadeguata, la perdita di dati o un problema organizzativo. La mancanza di ridondanza è soltanto una delle possibili cause.
Questo non rende la ridondanza meno importante. Al contrario, rappresenta uno degli ambiti attraverso i quali la Continuità Operativa può ridurre il rischio che un singolo guasto interrompa un processo critico.
La domanda quindi non è semplicemente:
“Il sito è ridondato?”
Ma:
“Quali rischi possono interrompere i processi che producono valore e quali strumenti, tra cui la ridondanza, possono ridurne le conseguenze?”
Due non significa sempre ridondante
Immaginiamo un’infrastruttura con una linea di rete dati principale e una linea di backup.
Sulla carta esistono due collegamenti.
Ma se entrambe le linee attraversano lo stesso cavidotto, un singolo evento può interromperle contemporaneamente.
La ridondanza esiste quindi soltanto apparentemente.
Lo stesso principio vale per molte altre situazioni: due sistemi possono condividere un’alimentazione, due server possono dipendere dalla stessa infrastruttura, due servizi possono avere una stessa dipendenza.
In questi casi esiste un Single Point of Failure (SPOF): un elemento il cui guasto può compromettere contemporaneamente le alternative disponibili.
La domanda non è quindi soltanto:
“Ho una seconda componente?”
Ma:
“Le due alternative possono essere colpite dallo stesso evento?”
La ridondanza deve essere indipendente
La vera ridondanza richiede che le alternative siano sufficientemente indipendenti dal punto di guasto che si vuole proteggere.
Questo non significa necessariamente che debbano essere completamente separate sotto ogni aspetto.
Significa che bisogna comprendere quali dipendenze condividono e quali eventi potrebbero comprometterle contemporaneamente.
È lo stesso principio che abbiamo incontrato analizzando infrastrutture apparentemente molto robuste: un’intera architettura può essere ridondata, ma un singolo elemento comune può annullare il beneficio della ridondanza.
Per questo l’analisi della Continuità Operativa non si limita a contare le componenti.
Segue le dipendenze.
La ridondanza non riguarda soltanto l’infrastruttura
Il concetto diventa ancora più interessante quando lo si osserva dal punto di vista dei processi critici.
Un processo può dipendere da una componente senza che sia necessario duplicare quella componente per proteggerne la continuità.
Immaginiamo un modulo di contatto che invia il lead tramite posta elettronica.
Sito → email → commerciale
Se il messaggio non viene consegnato e il lead non viene conservato da nessun’altra parte, l’indisponibilità del servizio di posta può trasformarsi nella perdita del lavoro già svolto.
Una soluzione semplice può essere quella di conservare temporaneamente il dato nel database del sito, così da poterlo recuperare e completare successivamente il processo.
In questo caso non abbiamo necessariamente creato un secondo sistema di posta.
Abbiamo protetto il processo dalla perdita del lavoro già svolto.
Questa è una distinzione importante.
La ridondanza non deve essere interpretata soltanto come:
“Se questo componente si rompe, ne utilizzo un altro.”
Può significare anche:
“Se questa componente viene meno, il processo può continuare oppure posso recuperare ciò che è già stato fatto?”
Non tutto deve essere ridondato
La Continuità Operativa dei siti web non stabilisce che ogni componente debba avere un duplicato.
Una ridondanza può avere costi molto elevati e non sempre è proporzionata al valore che protegge.
Un piccolo sito potrebbe non avere alcun senso nel duplicare completamente la propria infrastruttura.
Un servizio che genera valore continuamente potrebbe invece richiedere livelli di protezione molto maggiori.
La decisione dipende da diversi fattori:
- valore del processo che si vuole proteggere;
- conseguenze di una sua interruzione;
- probabilità che si verifichi il guasto;
- tempo necessario per ripristinare il servizio;
- costi della soluzione;
- capacità di recuperare il lavoro già svolto;
- livello di continuità già offerto dai servizi acquistati.
La domanda quindi non è:
“Quanto posso rendere ridondante il mio sito?”
Ma:
“Quanto vale la continuità di questo processo e quale livello di protezione è proporzionato?”
Anche il provider fa parte del ragionamento
Quando si acquista un servizio infrastrutturale, non è sempre necessario ricostruire autonomamente tutte le misure di ridondanza.
Un provider può già offrire una parte della protezione necessaria alla propria infrastruttura.
Questo però non significa che ogni rischio sia automaticamente trasferito al provider.
Occorre comprendere che cosa protegge il servizio acquistato e che cosa rimane sotto la responsabilità dell’organizzazione.
La Continuità Operativa richiede quindi di conoscere anche le dipendenze e le caratteristiche dei servizi utilizzati.
Non basta sapere che un servizio è “ridondato”.
Bisogna capire che cosa significa realmente quella ridondanza e quali eventi è in grado di gestire.
La ridondanza non è continuità finché non sai cosa succede
Avere un componente alternativo è soltanto una parte della soluzione.
Bisogna anche sapere cosa accade quando il componente principale viene meno.
Il passaggio verso il sistema alternativo prende il nome di failover.
Può essere automatico oppure richiedere un intervento.
Ma in entrambi i casi deve essere previsto.
Una ridondanza che nessuno sa utilizzare quando serve potrebbe non offrire il livello di continuità che ci si aspettava.
Per questo, quando si valuta una soluzione ridondata, una domanda fondamentale è:
“Cosa succede quando dobbiamo realmente utilizzarla?”
E, quando il livello di rischio lo richiede, occorre anche verificare che il comportamento previsto corrisponda a quello reale.
Dalla componente al processo
La prospettiva della Continuità Operativa porta quindi la ridondanza oltre la semplice duplicazione delle componenti.
Un server può essere ridondato.
Una connessione può essere ridondata.
Un sistema di alimentazione può essere ridondato.
Ma anche un processo può essere progettato in modo da non perdere immediatamente il lavoro quando una sua dipendenza diventa indisponibile.
Il punto di partenza rimane sempre lo stesso:
quale valore deve continuare a produrre il sito?
Da questa domanda si individuano i processi critici.
Dai processi critici si individuano le dipendenze.
Dalle dipendenze si possono individuare i punti nei quali un singolo guasto potrebbe interrompere il processo.
E solo a quel punto diventa possibile valutare se la ridondanza sia realmente necessaria, quale forma debba assumere e quanto sia conveniente investire per ottenerla.
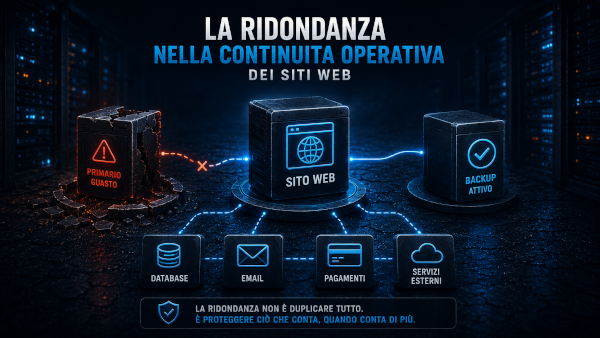
La ridondanza non consiste nel duplicare tutto. Consiste nel fare in modo che un singolo evento non interrompa ciò che è importante continuare a fare.
È per questo che la ridondanza, nella Continuità Operativa dei siti web, non è un obiettivo tecnico in sé.
È uno degli strumenti attraverso i quali si protegge la continuità dei processi che producono valore.
Approfondimenti
VPS: il cluster che non sai di avereIl nome va qui
Una VPS non è necessariamente legata a un solo server fisico. Se viene eseguita su un’infrastruttura composta da più nodi, un guasto hardware può permettere alla macchina virtuale di essere spostata o riavviata su un altro nodo. Per questo, quando si sceglie una VPS, è importante conoscere non solo le risorse assegnate, ma anche l’infrastruttura che la ospita e cosa succede in caso di guasto.
Approfondimenti
Gli articoli che seguono mostrano come i principi descritti in questa pagina si manifestano nella realtà: problemi, situazioni e casi concreti aiutano a capire perché questo aspetto è importante per la Continuità Operativa.
Per 11 giorni nessuno si è accorto che il sistema era rotto.
Per 11 giorni il sistema ha perso contatti senza che nessuno se ne accorgessePer 11 giorni il sistema ha perso contatti senza che nessuno se ne accorgesseIl sito funzionava. Il modulo contatti funzionava. Gli utenti continuavano a compilare il form e a inviare le loro...